

400-820-8531
 图1. 系统设计质谱的蛋白酶质组学现状分析(图源:Shuken, J Proteome Res, 2023)
01.数据统计探讨:多肽评定
累计LC-MS/MS正常运行产生的最原始记录源集有的是个大的光谱分析图碰面,没个光谱分析图都会有继承的时间、m/z值、标准和元资料源。选用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等工具包治理那些资料源,转换肽和/或淀粉酶酶质下拉列表,没个甄别都会有条个考试分数。绝对多数数非靶向疗法的自下而上的DDA淀粉酶酶质组学研究中食用的常用见的肽亲子鉴定技术为资料源库搜寻(图2)。
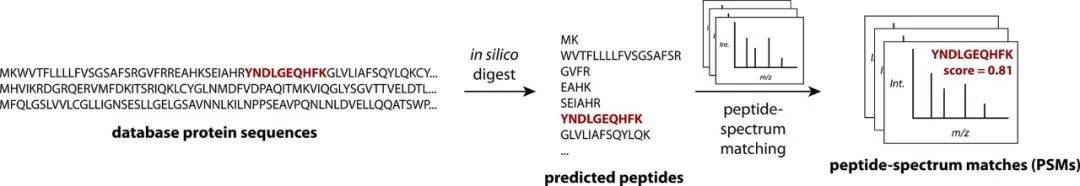 图2. 数据显示库检索的细化说明(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的氨基酸等字段(图源:Shuken, J Proteome Res, 2023)
 图4. 情节m/z值、带引用的MS2谱,已经图3中突显表示的情节编码序列(NILIDFTK)
1.1 参数库快速搜索法求实例:SEQUEST的优化叙说
SEQUEST是1996年出版业的首批全主动肽自动识别pc软件。图5演绎了SEQUEST图像一致的简单化的概念。应当,对学习核胆固醇组预计分析的肽实行过滤水系统,烦请只来考虑与拆分的裂开化合物的m/z值相近的前体(即电荷量睡眠状态特女性朋友肽化合物),以后提取的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析(图5,壳体)。确定将科学科学实验所室光谱仪仪分析仪分析仪仪分析分析分析分析与预计分析细节描写的m/z值实行初略是比较,的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析被短时间过滤水系统,一致细节描写的人数、MS2难度和两种重要性表现形式組分解这个高考成绩,仅留存根据该高考成绩的前500个的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析(图5,流程1)。确定彻底消除前体峰,将光谱仪仪分析仪分析仪仪分析分析分析分析分为五个等于的区城,并将每隔区城的难度归一改成重复的值来整改科学科学实验所室光谱仪仪分析仪分析仪仪分析分析分析分析(图5,流程2),这一歩使科学科学实验所室光谱仪仪分析仪分析仪仪分析分析分析分析更比较接近于的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析,以减少了建设的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析时忽略掉的可调皮肤破碎化成功率的。确定将每隔m/z值处的难度相乘并将乘积求和,核算科学科学实验所室光谱仪仪分析仪分析仪仪分析分析分析分析与每隔的认识论研究光谱仪仪分析仪分析仪仪分析分析分析分析中间的相护的关系(图5,流程3)。
 图5. 减化了原SEQUEST统计资料库寻找计算方式的方法(图源:Shuken, J Proteome Res, 2023)
1.2 肽亲子鉴定中的FDR操控
大家怎么样考虑哪方面高考分数线足够了高来表示法真是的ID?当前截止,最最火的形式是 Target-decoy百度搜素(图6)。该时候掌握全部有误察觉到率(FDR),即被接受了的PSM有误的平均水平比列。为着在掌握FDR的还大程度地检则真肽,可不可以运用百度搜素高考分数线和PSM的一些的特征的直线组合起来公式(图6)。直线组合起来公式中运用的数值{a, b,…}被网站SEO优化以大程度地检则真肽,基本运用percolator运用的产品培训汉明距离。抱歉网站SEO优化顺利完成后,每个高于所需要的FDR相配备阀值的目的配备(诸如,1%)被保存。这过虑数据统计集的FDR被称作“全部”FDR。
 图6. Target-decoy搜索引擎。PSM=肽谱适配;FDR =不正确的出现率(图源:Shuken, J Proteome
02.肽段化学发光法
优质色谱仪色谱在整体的行驶时候中累计地将多肽喷雾器到质谱仪中。每种扫一扫时期连续,普通须要3 s或很少,光谱仪图仪变成MS1光谱仪图;以至于,在优质色谱仪液相色谱柱过柱时候中,前体的MS1峰长期被看到无数次,这么多MS1数剧点同吃变成色谱峰(图7A)。给定特定的的肽,其色谱峰的特点,与其极高或曲线拟合上边积(AUC),快速适用于侧量肽的相对性丰度,这被通称非标设备记酶联免疫法(LFQ),该技术快速适用于各种不同打样定制中的的数量相对较。 成了提升酶联免疫法再现性、打样定制通量和/或数据库完整的性,标示药剂学药品适用于酶联免疫法某个质谱中的很多菌物学学工程体打样定制。在他们的方式中,除非各个的放射性核素会导致肽或其情节的m/z值各个外,肽被标示为差不多的原子团群,同样补齐药剂学特性,如补齐时、电离性和情节模式切换。在新陈代谢标示的方式中,如神经元养育安基酸可靠放射性核素标示(SILAC),利用率菌物学学工程体设备将含有重放射性核素的安基酸标示一小部分淀粉酶质组。在打样定制制取开始了时,将先天“轻”淀粉酶与重淀粉酶紧密联系,第三与MS1光谱仪做对比(图7B)。在等压法(即产品一一对应,是由于各个的那些固化的商品标签含有差不多的总产品)标示的方式中,如电容串联产品那些固化的商品标签(TMT),肽段在消化酶后被标示,第三在LC-MS/MS前女子组合。低能CID(HCD)为每位菌物学学工程体打样定制增加各个的统计阴正离子;借助MS2或MS3扫一扫在测量统计阴正离子效果,还可能得出出较为丰度(图7C)。适用LFQ,只要一适用定性分享1个菌物学学工程体样表;适用SILAC,只要一适用一般是定性分享两到4个菌物学学工程体样表;适用TMT,两次还可能定性分享几斤18种各个的菌物学学工程体样表。
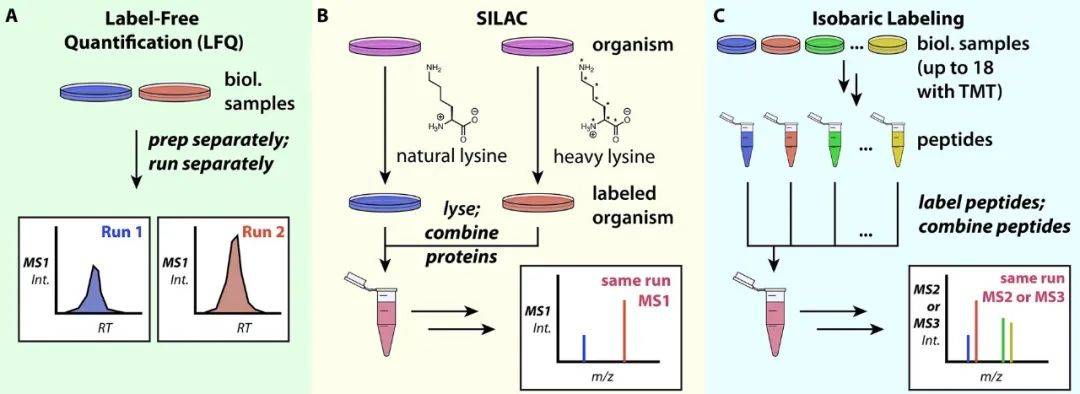 图7. 多肽降钙素原检测形式。A.在MS1平均水平确定非标准记降钙素原检测;B. 细胞膜养成中氨基安全稳定拉曼光谱标上(SILAC);C. 等压标上
03.“血清酶质平均水平”:推断出血清酶质的特征和丰度
3.1 球高蛋白判定与分类
尽量一系采用自下而上蛋清质组学说起了“蛋清质”的角色和次数,但我们一般是技术鉴定会和/或评定蛋清质群,其发源地的蛋清质或dna可能会是不明晰的。而对于各种歧义句,常用见的处理好方案设计是采用每一家PSM成为合格品中产生应当蛋清质的书证。假设每组蛋清质相互间有相同的书证(即蛋清质回文编码序列与同每组技术鉴定会的肽回文编码序列相配,长为8中的蛋清质V和VI),则将这样的蛋清质組合为1个蛋清质组(PG)。假设1个蛋清质的相配肽是另1个蛋清质的子集,则该蛋清质一般被判定在数据以外,而没有该蛋清质奇特肽但其肽不算子集的蛋清质是指可包函蛋清质。
 图8. 核营养素推测和分类方案(图源:Shuken, J Proteome Res, 2023)
3.2 球蛋白总体水平FDR调控
多半数执行命令血清质组群的时髦系统包,如MaxQuant和Proteome Discoverer,也行计算的血清质技术亲子鉴定FDR的可能,并将其可以直接调准到可联受的技术。有不同方法步骤行掌握血清质技术的FDR。的可以直接的攻略是回收利用钓饵PGs,即全由钓饵PSM根据的PG,这些食品被自己抹去并得到与工作要求PSM不同的血清质测算具体步骤。为各个工作要求和钓饵PG创造出其中一个其中一个考分,同意以与PSM FDR看起来像的习惯掌握血清质技术FDR(图6)。3.3蛋白质组一定量
多肽和血清质真正的爱情内在联系的相互面情况使这样的过程中较为复杂化。PG内的肽或许在二者自动匹配的血清质中真正的爱情各种与众不同于,这或许会危害力二者的丰度(图8)。如PG中的肽是该PG所独特的的,这就是有作用的,合法对独力血清质顺利通过量化分析。或许,较为复杂化的是肽或许引发于含带英译后呈现的血清质,其丰度危害力肽的难度,最后,伴随DDA确定性的随机数性,一款 肽或许在一款 备样中观查到而在别的款 备样中观查没法。时髦时尚的的参数解决应用包为用户组提供参数清楚决这样的的问题的选项卡。许多数应用(还包括MaxQuant)只合法对PG-unique肽顺利通过酶联免疫法。一款 (如Spectronaut ,Biognosys)合法更好地的规格为,如受到限制酶联免疫法到血清质特情人肽,或选泽是否能够按照肽难度的中十十位数、和、逻辑运算分別值或怎么样分別值来计算出来PG人数。针对于LFQ,应当注意事项的是MaxQuant中保证的时髦时尚的MaxLFQ计算方式。当在各种与众不同于的样品中辨识出各种与众不同于的前体集时,MaxLFQ顺利通过按照可以的两两很和按照中十十位数比重来很PG来解决不全值。等压标志和的参数独力抓取(DIA)是减小或消去不全值的别的策略。3.4 分享分享和海洋物理学描述
要是算出PG的相较次数,会根据实验性室的分子生物学学基本特征,应该用到各方面生产工具对后果完成深入阐述深入阐述和解悉。Perseus和MSStats是的设计主要用于蛋清质组次数正确处理和深入阐述深入阐述的出名app包。数剧调查统计也应该用到编写程序语言表达方式(如python或R)全自动深入阐述。在一般来说较为蛋清质组学实验性室中,其中包括从下拉列表中除掉影响物或诱耳,用到对数计算使次数相当于正态布局,将数剧调查统计归一化以改正利用间的技术工艺进化性,用到深入阐述开展员(如t开展员/方差深入阐述/非线性归来)开展员變化,并对后果p值完成多假设查验开展员。 测算深入定性讲解搞定后,成果能否用生态学学描述。Gene Ontology是论述在测试中发现转换的生态学渠道的个留行的比对库。STRING展示了关与感动手能力的蛋清酶质充分相互求该的联系的或充分功用的信心。关于深入定性讲解,如权重计算dna关于无线电脑网络深入定性讲解(WGCNA),只能根据测试中蛋清酶质丰度发生改变的差不多状态打造蛋清酶质无线电脑网络,这能否进每一步了解一下测试中蛋清酶质充分相互的的联系的。用综合评估描述这样深入定性讲解的成果,生态学学假定能否得到了的支持或辩解,而且能否所产生新的假定。04.拜谱怪物总结报告:质谱操作具体步骤
总的来,非标设备记的自下而上的工作的过程以下的: (1)区分聚集/沉水植物、消融上皮细胞;用尿素溶液和/或去垢剂使球蛋白男变女。 (2)用DTT或TCEP等办法减掉二硫化橡胶物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇沉垫出的法或磁珠沉垫出的法一部分纯化淀粉酶质(有点作业环节不适用微害的去垢剂如SDS,可绕开这每一步)。 (4)用胰淀粉酶质酶或LysC组合名字淀粉酶质酶代谢淀粉酶质质。 (5)用C18包被的过虑吸管头离心分离分离家电清洗/脱盐多肽;用真空环境离心分离分离机等化掉溶液。 (6)将肽重悬于LC-MS兼容的萃取剂中,假如0.1%甲酸水悬浊液;所采用相对应的仪器设备的方式实现LC-MS/MS分析一下;在程序运行到位后检索系统原统计数据。 (7)运行适宜的手机app包处置原状数值,如MaxQuant或Proteome Discoverer,或手机app包的组装,完成数值库搜、FDR调控、相较参考值和球营养物质判定。 (8)在使用文字编程文字(如python或R)或系统软件包(如Perseus或MSStats)进行总算数据分析。 (9)要根据实验操作的生理学学的基本原理来讲解毕竟;这也可以完成绝对路径或线上级了解能源(如Gene Ontology、STRING或WGCNA)来协助。 05最前沿核心
不仅DDA采取的非靶点自下而上的无记号淀粉酶质组,另外还有大多的科学设计背景质谱的方式方式方法步骤步骤来科学设计淀粉酶质组(图9)。设备和图像匹配均在敢于创新的更新换代,全部淀粉酶质、遵循原则和本身质谱法也在设计低简化性的样本量;淀粉酶的翻泽后修饰语而使至关首要的宏观调控的用处具有好的科学设计新天地。格局淀粉酶质组学、化工淀粉酶质组学和靠近记号等科技实用化工、酶或热科技来监测淀粉酶质,为科学设计淀粉酶质格局、化工、固定、淀粉酶质-配体主动的用处或淀粉酶质-淀粉酶质主动的用处开拓了过量的时机。相对来说DDA,的数据统计显示孤立获取(DIA)就是种越多越受追捧的获取方式方式方法步骤步骤,最时髦的DIA方式方式方法步骤步骤是科学设计背景SWATH-MS,至少全MS1区间内的因此m/z值在每一家测试定期内都一般包括在皮肤碎片中,这很大程度提生了的数据统计显示全部性,增强了淀粉酶质组学淬硬层。在靶点淀粉酶质组学中,一个其他的淀粉酶质或四组淀粉酶质被充当设计的方向,其方向是切实保障次次方式方式方法步骤步骤正常运作时都能监测到方向淀粉酶质(的数据统计显示全部高朝),比较大装量地提生敏感度和情况区间,已经酶联免疫法明确性和紧密度。 针对于大人数的蛋清质认定和降钙素原检测,质谱法是当前最时髦的方法步骤,在前景,质谱与某些非质谱的技术的整合便用应该越深入地理解大部分生物制品学中的蛋清质组。
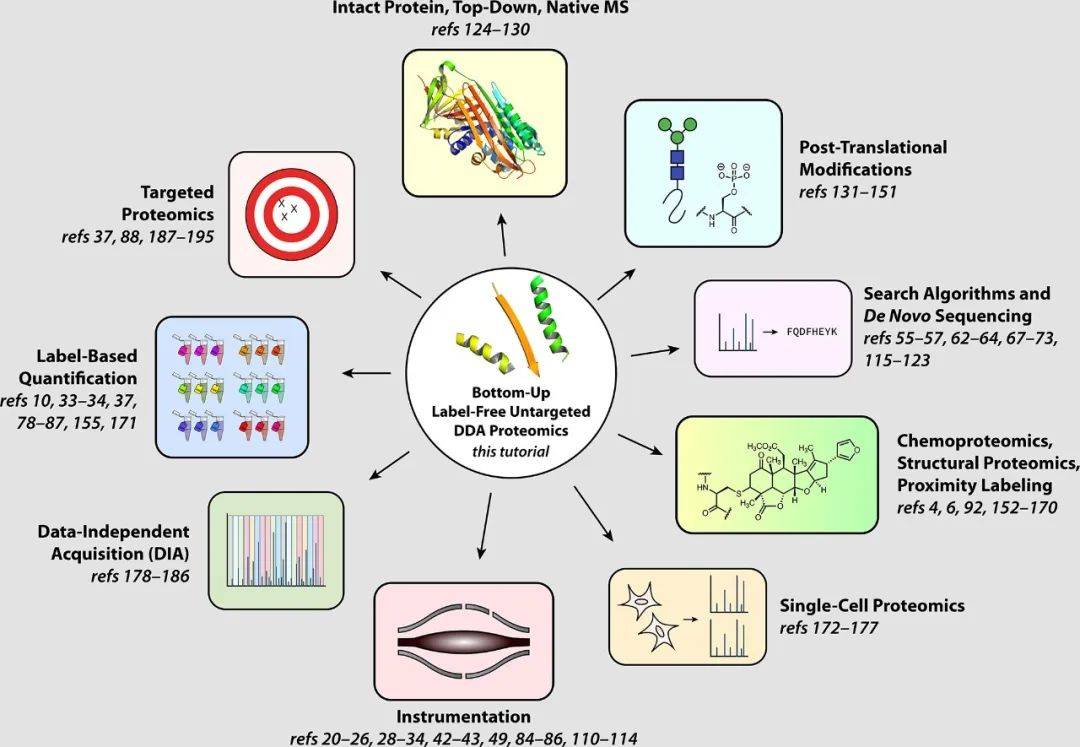 图9. 依据质谱的蛋白酶质组学的子行业(图源:Shuken, J Proteome Res, 2023)
学习论文资料:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 私信大家号


 关注公众号小丽书


